← 프로젝트 목록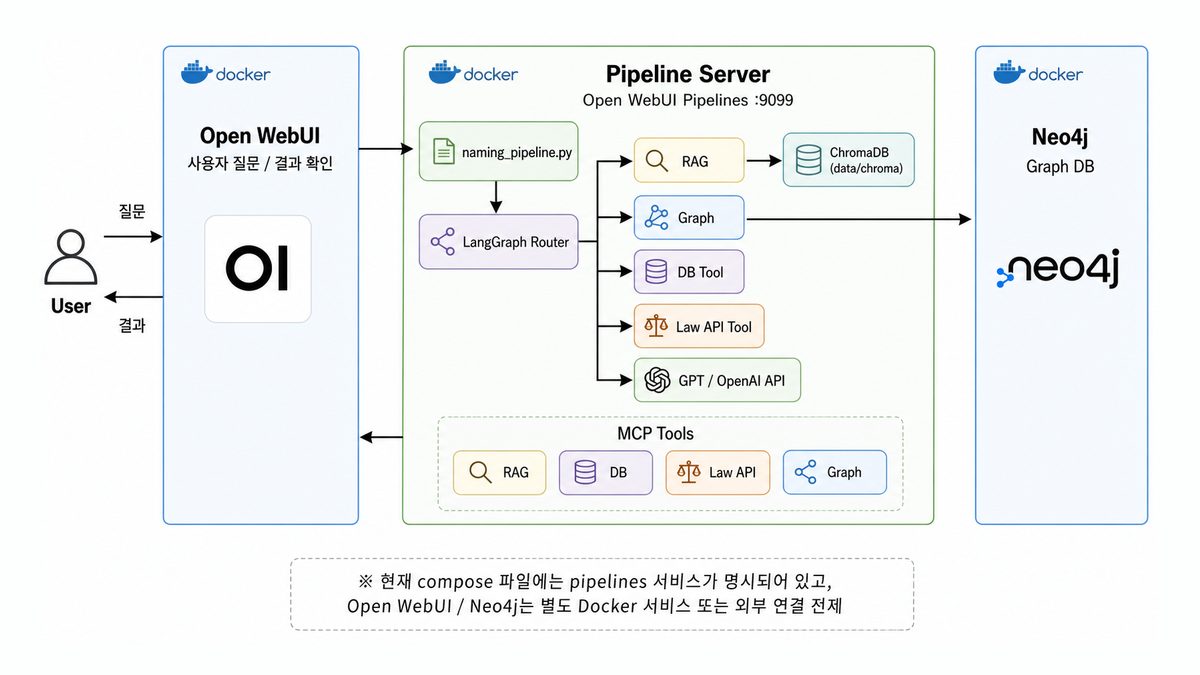
개요
자연어로 입력한 조건에 맞는 이름을 추천하고 법령 근거를 출처와 함께 제시하는 대화형 QA 시스템입니다. LangGraph ReAct Router가 RAG·계산·법령 API·그래프 네 경로로 분기하고 FastMCP 도구 16개를 호출합니다. 운영 파이프라인과 QLoRA 파인튜닝 모델을 11개 케이스로 예비 비교해(LLM 채점) 4.09점 대 1.63점이 나왔고, 4차 프로젝트에 RAG+Tool 구조를 채택했습니다.
맡은 일
- PM · 일정 조율 · 브랜치 병합
- 라우터 LangGraph ReAct 라우터(뼈대 · 도구 선택 루프 · 반복 호출 차단) 작성
- 평가 평가 스크립트 2종과 비교 평가 보고서 작성
- 모델 교체 운영 모델 교체 결정과 보고서 작성
구현과 문제 해결
- 라우터 같은 도구 반복 호출·JSON 파싱 실패·컨텍스트 누적을 막으려고 도구 사용 이력으로 중복 차단, 도구 이름 검증, 컨텍스트 8,000자·반복 5회 상한
- 모델 교체 Qwen3.5 4B가 같은 문장 반복·형식 불이행·획수 환각을 보이고 파라미터 조정으로도 해결되지 않아, 라우터와 생성 모델을 나누고 OpenAI 모델로 교체
- 검색 "3개 추천"의 3을 3획으로 찾던 의미 검색 오탐을 오행 필터 + 무작위 샘플링 방식으로 전환
- 평가로 버그 수정 LLM 채점 평가에서 드러난 버그 7건(수리 질문 반문 오발동, 숫자 추출 정규식, 오행 한자를 성씨로 오인 등) 수정
결과
- 평가 평균 3.73 → 4.09, 수리 계산 케이스 2.33 → 5.00
- 예비 비교(11개 케이스, gpt-5.4 채점, 사람 검수 없음): RAG+Tool 4.09점 vs QLoRA 파인튜닝 1.63점 → 4차에 RAG+Tool 구조 채택
- 한계 버그 수정에 쓴 케이스로 다시 채점해 평가셋 과적합 가능성, 두 방식의 지표 구성이 달라 공통 지표로는 근거성 3.82 vs 1.50
- 소속
- SK네트웍스 Family AI 캠프
- 기간
- 2026.06
- 구분
- 3차 프로젝트 (4인)
- 역할
- PM · LangGraph 라우터 · 평가 · 서버 인프라
- 기술
- LangGraphFastMCPChromaDBNeo4jOpenAI APIQLoRA